Пайплайн даних (ETL) для малого бізнесу: як зібрати все в одному місці
Що таке ETL/ELT простими словами, як зібрати дані з GA4, реклами, CRM (KeyCRM, Bitrix24, HubSpot), магазину й платежів у BigQuery чи PostgreSQL, скільки це коштує в підтримці і чого уникати.
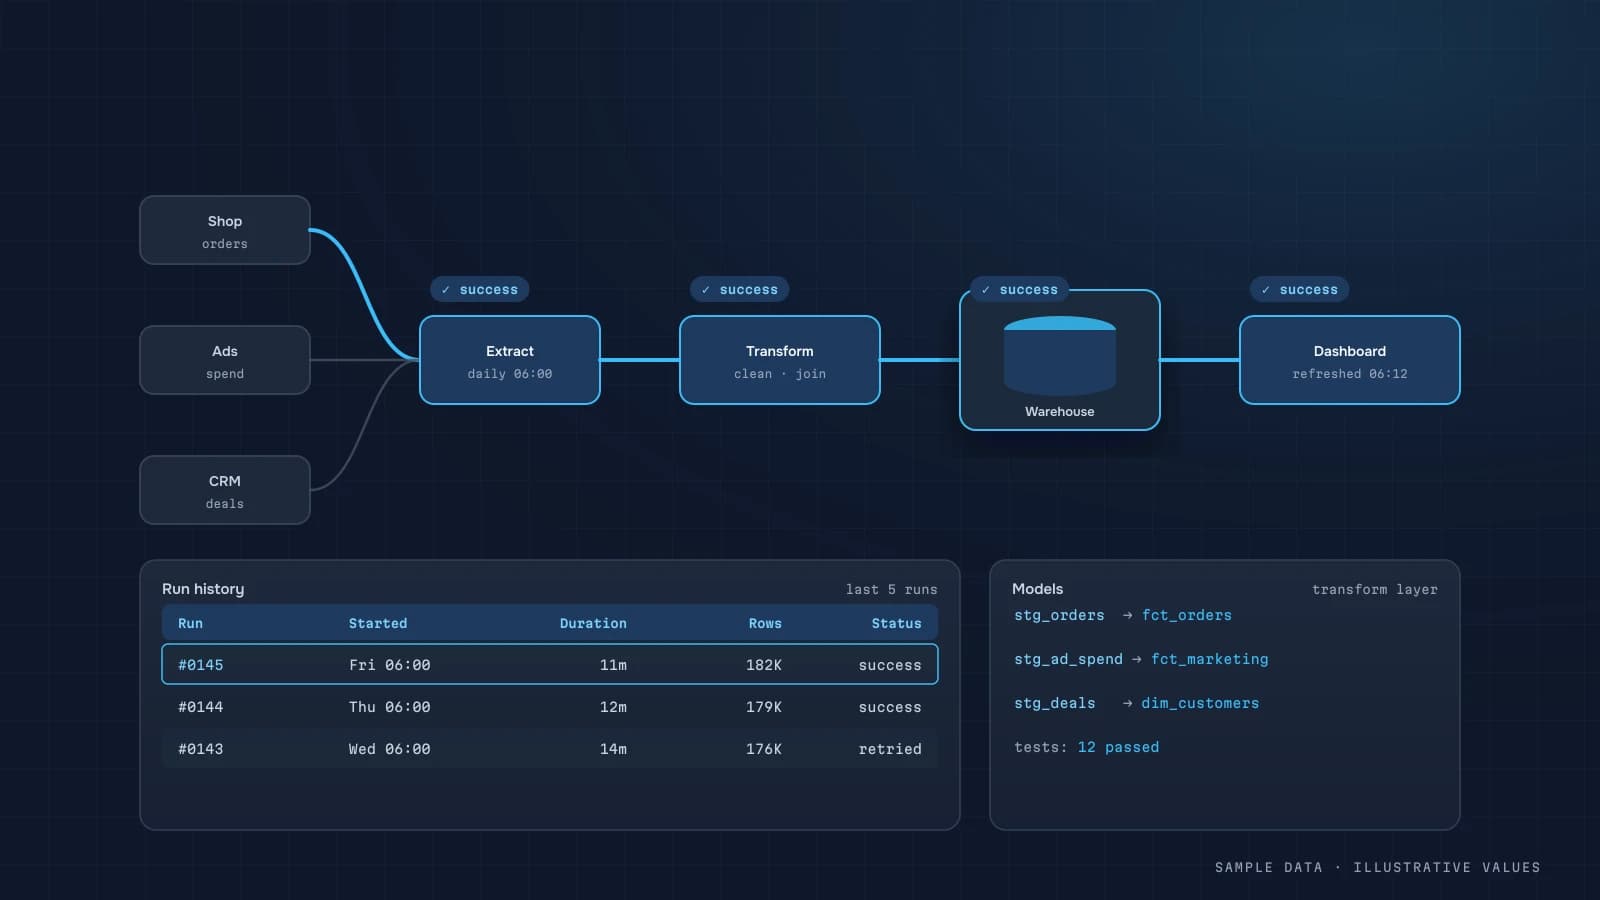
Дані малого бізнесу зазвичай лежать у п'яти-десяти місцях: CRM, рекламні кабінети, GA4, адмінка магазину, платіжний сервіс, кілька Google Таблиць. Щоб побачити картину, хтось щопонеділка зводить їх вручну. Пайплайн даних робить це автоматично — щоночі, однаково, без помилок копіювання.
ETL і ELT простими словами
- Extract — забрати дані з джерела (API, база, файл).
- Transform — очистити, привести до єдиного формату, з'єднати.
- Load — покласти у сховище.
У класичному ETL трансформація відбувається до завантаження. Сьогодні частіше роблять ELT: спочатку кладуть сирі дані у сховище, а потім трансформують SQL-ом усередині нього. Це простіше відлагоджувати й можна перерахувати історію, якщо змінилося визначення метрики.
Типова архітектура для малого бізнесу
| Шар | Технологія | Що там |
|---|---|---|
| Джерела | GA4, Google Ads, Meta Ads, KeyCRM/Bitrix24/HubSpot, Shopify/Horoshop/Prom, LiqPay/monobank, Sheets | як є |
| Завантаження | скрипти на Python за розкладом або готові конектори | інкрементально, щоночі |
| Сховище | BigQuery (якщо вже є GA4 export) або PostgreSQL | сирі таблиці raw_* |
| Моделі | SQL-перетворення | orders, customers, ad_spend, sessions |
| Вітрини | агрегати | daily_kpi, channel_perf, cohorts |
| Споживачі | дашборд, Telegram-звіти, ШІ-асистент |
BigQuery чи PostgreSQL
| BigQuery | PostgreSQL | |
|---|---|---|
| Коли | вже є експорт GA4, великі обсяги подій | дані переважно з CRM і магазину, помірні обсяги |
| Оплата | за зберігання і прочитані дані (тарифи) | за сервер |
| Адміністрування | майже немає | бекапи, оновлення |
| Де дані | Google Cloud, регіон обираєте | ваш сервер чи хмара |
Нерідко використовую обидва: GA4 лишається в BigQuery, а бізнес-дані і вітрини для кабінету — у PostgreSQL на сервері клієнта.
Джерела: що варто знати про кожне
GA4 — найкраще через нативний експорт у BigQuery, а не через API звітів: немає квот і семплювання.
Google Ads / Meta Ads — API віддають витрати, покази, кліки й конверсії кабінету на рівні кампанії/оголошення за день. Завантажуйте з перерахунком останніх 7–30 днів: платформи оновлюють конверсії заднім числом.
CRM (KeyCRM, Bitrix24, HubSpot) — джерело правди про замовлення й ліди. Важливо забирати зміни статусів (оплата, повернення), а не лише нові записи — інакше виручка «пливе».
Платформи магазинів (Shopify, Horoshop, Prom) — замовлення, товари, залишки. Перевіряйте, які поля доступні в API вашого тарифу.
Платежі (LiqPay, monobank, Stripe) — фактичні суми, комісії, повернення. Документація: LiqPay API, monobank acquiring API.
Google Таблиці — плани, собівартість, ручні довідники. Зручно, але потрібна валідація: одна зайва кома ламає звіт.
Принципи надійного пайплайна
- Інкрементальне завантаження з «вікном перерахунку» — завантажуємо зміни за останні N днів, а не все щоразу.
- Ідемпотентність — повторний запуск за той самий день не створює дублікатів (upsert за ключем).
- Сирі дані окремо — ніколи не трансформуйте «на місці»; збережіть оригінал.
- Перевірки якості — порожні дні, різке падіння кількості рядків, дублікати ID, від'ємні суми.
- Сповіщення — якщо завантаження впало, ви дізнаєтесь уранці в Telegram, а не через тиждень від власника.
- Ключі лише на сервері, доступи — мінімальні, лише на читання.
- Документація метрик поруч із кодом.
Приклад перевірки якості (SQL)
-- день без замовлень або різке падіння: сигнал зламаного завантаження
WITH d AS (
  SELECT order_date, COUNT(*) AS n
  FROM orders
  WHERE order_date >= CURRENT_DATE - INTERVAL '35 day'
  GROUP BY 1
)
SELECT order_date, n,
       AVG(n) OVER (ORDER BY order_date ROWS BETWEEN 28 PRECEDING AND 1 PRECEDING) AS avg28
FROM d
WHERE n < 0.4 * AVG(n) OVER (ORDER BY order_date ROWS BETWEEN 28 PRECEDING AND 1 PRECEDING);Готові конектори чи власний код
| Готові ELT-сервіси | Власні скрипти | |
|---|---|---|
| Старт | швидко | довше |
| Вартість | підписка, часто за обсяг рядків | сервер + час розробника |
| Локальні сервіси (KeyCRM, Horoshop, monobank) | часто немає конектора | будь-які API |
| Гнучкість | обмежена | повна |
| Залежність | від постачальника | від того, хто підтримує код |
Для українського стеку локальних конекторів часто немає, тому я зазвичай поєдную: нативний експорт GA4 + власні легкі завантажувачі на Python для CRM, магазину й платежів.
Скільки це коштує в підтримці
Окрім інфраструктури (сервер, BigQuery), основна стаття — зміни в джерелах: API оновлюють версії, у CRM додають поля, маркетолог міняє UTM. Закладайте кілька годин на місяць на супровід; без цього пайплайн тихо ламається.
Що отримує бізнес
- щоранку актуальні цифри без ручного зведення;
- одна версія правди замість «у мене в таблиці інакше»;
- можливість рахувати юніт-економіку і когорти;
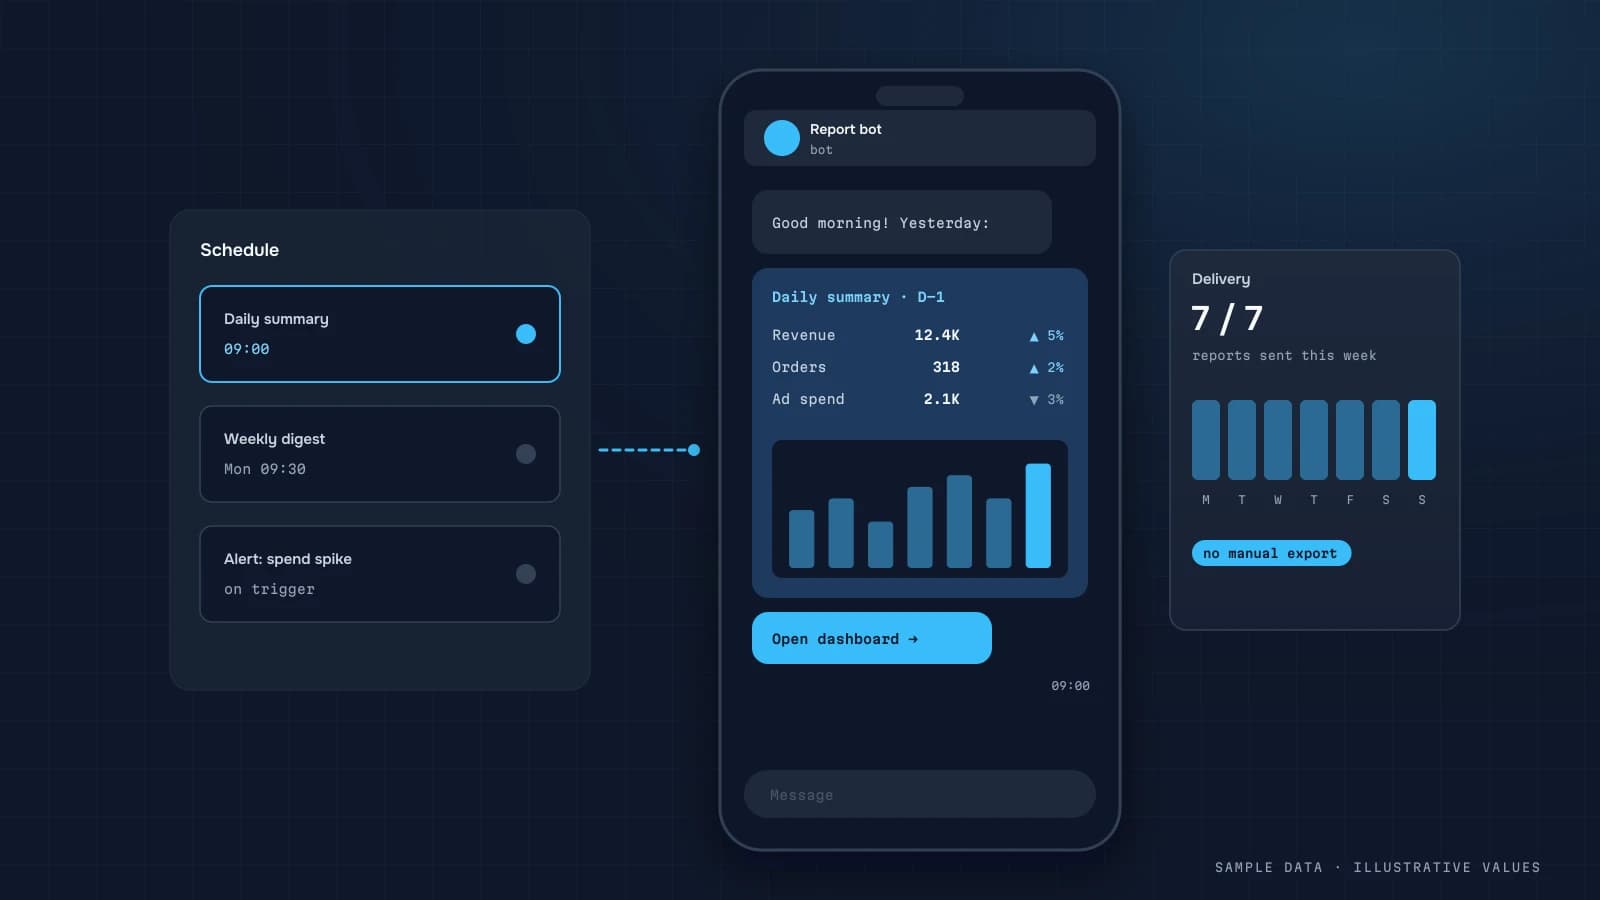
- автозвіти в Telegram і ШІ-асистента, який відповідає на запитання по ваших даних.
Чекліст запуску пайплайна
- Список джерел, власників доступів і ключових полів
- Обрано сховище і регіон
- Сирий шар відокремлено від моделей
- Інкрементальне завантаження з вікном перерахунку
- Upsert за ключами, без дублікатів
- Перевірки якості й сповіщення про збої
- Ключі в змінних середовища сервера
- Словник метрик і схема даних задокументовані
Покроково: одне джерело, зроблене правильно
Ось повний шлях для одного джерела — API замовлень платформи магазину, — бо всі інші джерела йдуть за тим самим шаблоном.
1. Витягувати інкрементально. Не вивантажуйте всі замовлення щоночі. Запитуйте замовлення, оновлені після останнього успішного запуску, з запасом:
import datetime as dt, time, requests

def fetch_orders(api, since: dt.datetime):
    page, out = 1, []
    while True:
        r = requests.get(f"{api.base}/orders",
                         params={"updated_after": since.isoformat(), "page": page, "per_page": 100},
                         headers={"Authorization": f"Bearer {api.token}"}, timeout=30)
        if r.status_code == 429:                 # ліміт запитів: чекаємо і повторюємо
            time.sleep(int(r.headers.get("Retry-After", 10))); continue
        r.raise_for_status()
        batch = r.json()
        if not batch: break
        out.extend(batch); page += 1
    return out

# запас у 2 дні ловить пізні зміни (статуси, повернення)
since = last_success_at - dt.timedelta(days=2)
Саме оновлені, а не створені: замовлення, створене минулого тижня, можуть повернути сьогодні. Повторно прочитати кілька сотень рядків — розумна ціна за те, щоб не пропустити зміни.
2. Зберігати сирі дані без змін. Записуйте JSON як є в сиру таблицю з часом завантаження. Коли API зміниться або в трансформації знайдеться помилка, можна перебудувати все з сирих даних, не звертаючись до API знову.
3. Upsert у чисту таблицю. Зливайте за природним ключем, щоб повторні запуски ніколи не дублювали:
MERGE clean.orders t
USING (
  SELECT id AS order_id, status, CAST(total AS NUMERIC) AS total,
         TIMESTAMP(updated_at) AS updated_at
  FROM raw.orders_latest
  QUALIFY ROW_NUMBER() OVER (PARTITION BY id ORDER BY updated_at DESC) = 1
) s
ON t.order_id = s.order_id
WHEN MATCHED AND s.updated_at > t.updated_at THEN
  UPDATE SET status = s.status, total = s.total, updated_at = s.updated_at
WHEN NOT MATCHED THEN
  INSERT (order_id, status, total, updated_at) VALUES (s.order_id, s.status, s.total, s.updated_at);
QUALIFY лишає в пакеті лише найновішу версію кожного замовлення, а порівняння updated_at не дає старішому повторно прочитаному рядку перезаписати новіший.
4. Будувати вітрини з чистих таблиць. Щоденні зведення, таблиці каналів і когорт перебудовуються з clean.* за ковзне вікно (наприклад, останні 7 днів) на кожному запуску.
5. Перевіряти і сповіщати. Після кожного запуску перевіряйте кількість рядків і свіжість і надсилайте повідомлення, якщо щось не так (див. нижче).
Моніторинг: перевірки, що ловлять реальні проблеми
| Перевірка | Що ловить | Приклад правила |
|---|---|---|
| Свіжість | завислі задачі, прострочені токени | останній updated_at у clean.orders молодший за 26 годин |
| Обсяг | часткові завантаження, зміни API | вчорашні замовлення в межах 50–150% середнього за той самий день тижня за 4 тижні |
| Унікальність | дубльовані завантаження | order_id унікальний у clean.orders |
| Звірка | помилки логіки | вчорашня оплачена виручка збігається з платіжкою в межах 1–2% |
| Схема | тихі зміни API | очікувані колонки існують і не на 100% порожні |
Надсилайте збої туди, де їх читають (Telegram, email) — з назвою перевірки, значенням і посиланням на лог. Пайплайн, що падає мовчки, гірший за відсутність пайплайна: люди продовжують довіряти числам. Сповіщення можуть іти тим самим ботом, що й автозвіти в Telegram.
Типові сюрпризи
- Прострочені токени. Токени рекламних платформ спливають або відкликаються, коли людина йде з команди. Зберігайте власника токена і дату закінчення, сповіщайте за тиждень.
- Зміни схеми. API додають, перейменовують і прибирають поля. Сирий JSON (крок 2) перетворює більшість таких випадків на виправлення трансформації, а не на втрату даних.
- Часові пояси. Рекламні платформи звітують у поясі акаунта, магазини — часто в UTC. Приводьте все до одного бізнес-поясу в чистому шарі й запишіть це у визначеннях.
- Валюта. Зберігайте оригінальні валюту і суму, а також конвертовану суму з курсом і датою курсу.
- Довантаження історії. Додаючи нову метрику, ви захочете історію. Робіть кожну задачу з параметром діапазону дат, щоб довантаження було параметром, а не новим скриптом.
Приклад розкладу (ілюстративно)
| Час (бізнес-пояс) | Задача |
|---|---|
| 02:00 | рекламні платформи: витрати за 3 останні дні (платформи уточнюють свіжі дні) |
| 02:30 | магазин/CRM: замовлення, оновлені з останнього запуску − 2 дні |
| 03:00 | платежі: транзакції і повернення |
| 04:00 | експорт GA4 у BigQuery → таблиці сесій (після появи денної таблиці; повтор о 10:00, якщо запізнилась) |
| 05:00 | вітрини: щоденне зведення, канали, когорти |
| 05:30 | перевірки; сповіщення про збій |
| 07:00 | ранковий звіт |
Порядок важливий: вітрини запускаються лише після завантаження всіх джерел, а ранковий звіт — лише якщо перевірки пройшли. Якщо ні, звіт пише «дані запізнюються», а не надсилає неправильні числа.
Документація, яка тримає пайплайн у робочому стані
Пайплайн, побудований однією людиною, стає ризиком, щойно ця людина зайнята чи пішла. Короткий живий документ тримає його в робочому стані. У мене він завжди має однакові розділи:
| Розділ | Що там |
|---|---|
| Джерела | кожна система, що завантажується, як (API, експорт, вебхук), власник акаунта/токена |
| Розклад | порядок задач, час, очікувана тривалість |
| Таблиці | raw → clean → mart, по рядку на таблицю: що в ній і її ключ |
| Визначення метрик | посилання на словник, яким користуються дашборди |
| Перевірки | кожна перевірка, поріг, кого сповіщати |
| Інструкція на збій | що робити, коли перевірка впала: ймовірні причини і як перезапустити діапазон дат |
| Журнал змін | дата, що змінилося, чому |
Інструкція окупається вперше, коли щось ламається о 7 ранку. «Токен прострочено: перепідключіть у рекламному кабінеті, потім запустіть load_ads --from 2026-10-10 --to 2026-10-12» — це різниця між виправленням за 10 хвилин і втраченим ранком.
Домовленості з тими, хто вносить дані
Багато проблем пайплайна починаються раніше — в тому, як люди користуються CRM чи адмінкою магазину. Кілька явних домовленостей запобігають більшості з них:
- Статус замовлення означає одне. Якщо «виконано» іноді означає «оплачено», а іноді «відправлено», звіти з виручки «попливуть». Запишіть, який статус означає отримані гроші.
- Тестові замовлення позначені. Тег, тестовий клієнт чи окремий спосіб оплати — будь-що, за чим пайплайн може фільтрувати.
- Ручні знижки і повернення проходять через систему, а не окремими переказами, інакше звіти з маржі ніколи не зійдуться.
- Нові кампанії дотримуються конвенції UTM, інакше вони з'являються як «unknown» у звітах за каналами.
Домовитися про це нічого не коштує, а згодом економить години розслідувань. Зазвичай я збираю ці правила на одній сторінці й проходжу їх з командою під час запуску пайплайна.
Часті запитання
Скільки часу займає побудова пайплайна?
Для 4–6 типових джерел — зазвичай 1–3 тижні, залежно від якості даних і того, як швидко надаються доступи. Більше часу йде на звірку цифр, ніж на код.
Чи можна обійтися без сховища, просто підключивши BI до джерел?
Для одного-двох джерел — так. Коли треба з'єднувати CRM з рекламою й GA4, без сховища звіти стають повільними, а розрахунки — неузгодженими.
Де зберігаються дані — у вас чи в нас?
Я розгортаю сховище у вашій інфраструктурі або хмарному акаунті. Дані й код лишаються у вас, я працюю з мінімальними правами.
Як часто оновлюються дані?
Зазвичай раз на ніч; для реклами й замовлень можна погодинно. Частіше рідко потрібно і збільшує вартість.
DATUMPANEL — Аналітика даних для бізнесу
DATUMPANEL — це незалежний аналітик даних з України. Будую дашборди для власників бізнесу, налаштовую GA4 і експорт у BigQuery, збираю пайплайни даних і автозвіти в Telegram для e-commerce, сервісного бізнесу, SaaS і агенцій — від аудиту даних до рішень.