ІІ-асистент для бізнес-даних: як питати дашборд словами
Як працює ІІ-асистент над вашими даними — text-to-SQL, семантичний шар, обмеження доступу — де він корисний, де помиляється, і як впровадити його безпечно без витоку даних.
«Скільки ми заробили на повторних клієнтах у вересні?» — питання, яке власник бізнесу хоче поставити словами, а не шукати потрібний фільтр. Мовні моделі вже вміють перетворювати такі питання на запити до даних. Але між демо і робочим інструментом — кілька важливих рішень.
Як це працює
- Користувач ставить питання природною мовою.
- Модель отримує опис даних: таблиці, поля, визначення метрик.
- Модель генерує SQL (або виклик API семантичного шару).
- Запит виконується з правами користувача — лише на дозволених даних.
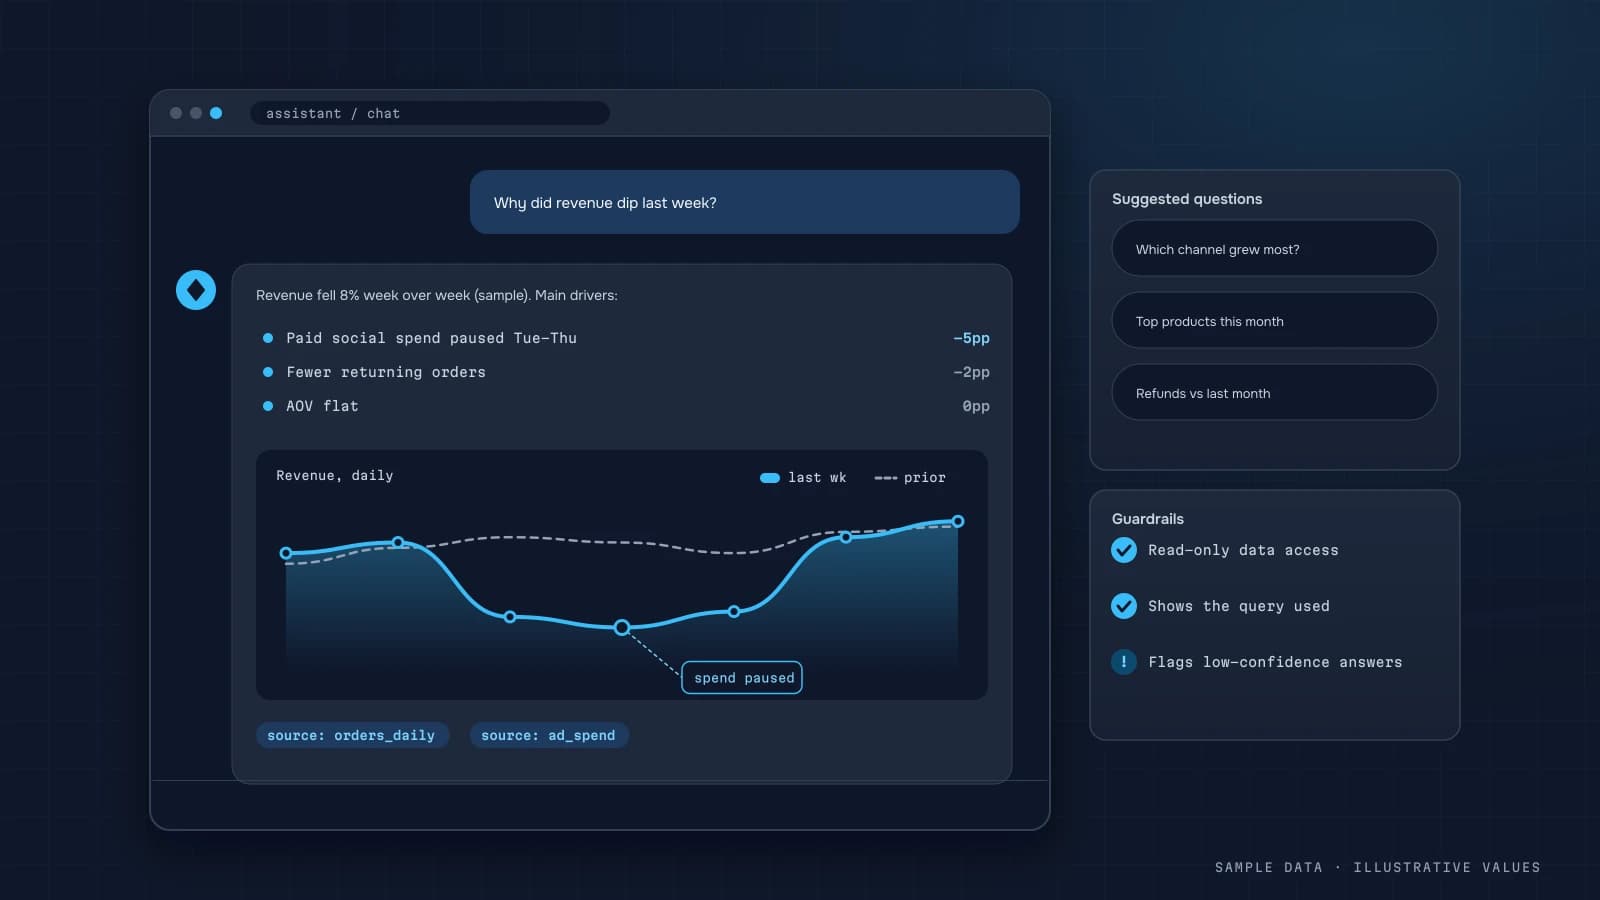
- Результат повертається таблицею/графіком і коротким поясненням, разом із самим запитом для перевірки.
Головне — семантичний шар
Найчастіша помилка: дати моделі сирі таблиці й сподіватися, що вона здогадається, що таке «виручка». Вона здогадається — по-своєму. Рішення — заздалегідь визначені метрики:
| Метрика | Визначення | Джерело |
|---|---|---|
| Виручка | сума оплачених замовлень мінус повернення | orders, refunds |
| Новий клієнт | перше оплачене замовлення в періоді | orders |
| CAC | витрати на рекламу / нові клієнти | ad_spend, orders |
| Маржинальний прибуток | виручка − собівартість − змінні витрати | див. статтю |
Коли модель обирає метрику з цього списку, а не вигадує формулу, відповіді збігаються з дашбордом. Це та сама одна версія правди, що й для звичайних звітів.
Де асистент корисний
- Швидкі разові питання, для яких не варто будувати окремий звіт.
- Пояснення змін: «чому впала виручка минулого тижня?» — розклад за каналами, категоріями, новими/повторними.
- Доступ для нетехнічних людей без навчання інтерфейсу BI.
- Чернетки запитів для аналітика.
Де він помиляється
- Неоднозначні питання («продажі» — кількість чи сума? з ПДВ?) — асистент має перепитувати, а не вгадувати.
- Складні часові розрахунки: когорти, ковзні вікна, порівняння з тим самим днем тижня.
- Дані, яких немає: модель може «впевнено» відповісти, навіть якщо потрібного поля немає. Тому показ SQL і даних обов'язковий.
- Причинність: асистент бачить кореляції, але не знає, що ви змінили ціни.
Безпека даних
| Ризик | Захист |
|---|---|
| Доступ до чужих даних | запити під обліковим записом користувача, row-level security |
| Модифікація даних | користувач БД лише з правом читання |
| Важкі запити | ліміти часу і рядків, виконання на репліці |
| Передача даних провайдеру ІІ | умови провайдера щодо навчання на даних; модель отримує схему, а не всю базу |
| Персональні дані | маскування email/телефонів у відповідях |
Для чутливих даних варто розглянути розгортання моделі в контрольованому середовищі або передачу моделі лише агрегатів.
Як впровадити поетапно
- Навести лад у визначеннях метрик (аудит аналітики).
- Зібрати набір з 30–50 реальних питань команди з правильними відповідями.
- Підключити асистента в режимі «лише для читання» і порівняти відповіді з еталоном.
- Дати доступ кільком користувачам, логувати питання і помилки.
- Розширювати семантичний шар за питаннями, на які асистент не впорався.
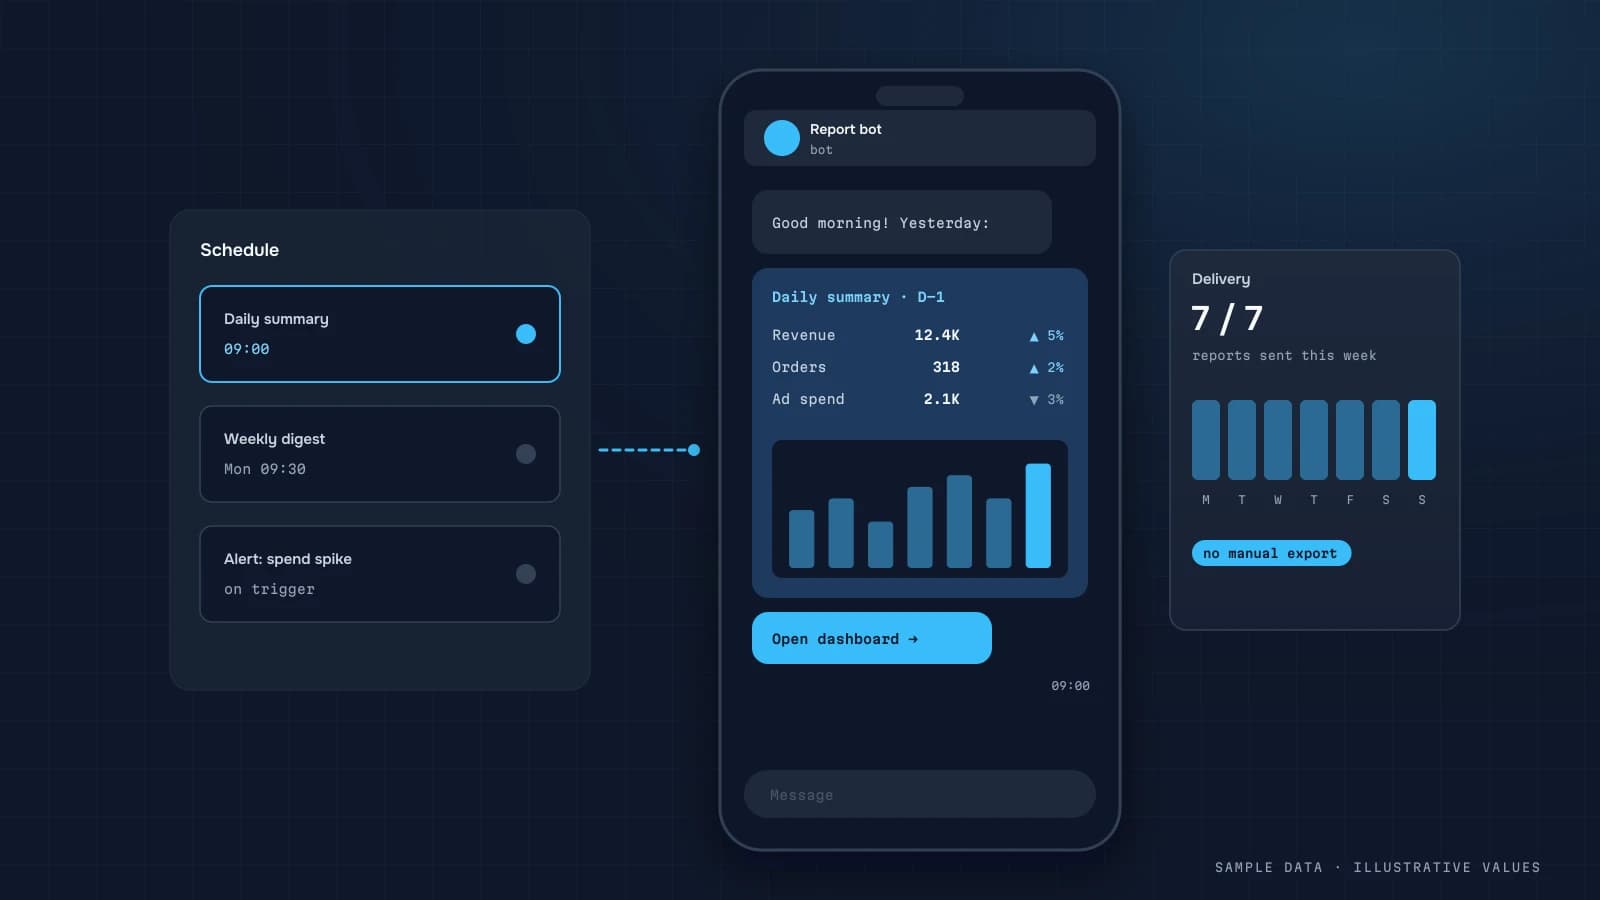
Асистент може жити і там, де команда вже спілкується, — наприклад, у Telegram поряд з автоматичними звітами.
Чекліст
- Метрики визначені в семантичному шарі
- Доступ лише на читання, row-level security
- Відповідь показує запит і дані
- Асистент перепитує неоднозначні питання
- Еталонний набір питань для тестування
- Лог питань і помилок
- Перевірені умови провайдера ІІ щодо даних
Покроково: мінімальне безпечне налаштування
- Створіть роль у базі лише для читання, яка бачить тільки звітну схему (вітрини і представлення), а не сирі таблиці з персональними даними.
- Напишіть семантичний контекст: короткий документ, який модель отримує з кожним запитанням, — таблиці, колонки, визначення метрик, ключі з'єднань, бізнес-часовий пояс, фінансовий календар.
- Обмежте відповідь. Просіть модель повертати один оператор
SELECTі перевіряйте його перед запуском: відхиляйте все, що неSELECT, примусово додавайтеLIMIT, задайте тайм-аут запиту. - Виконуйте запит із правами користувача, а потім передавайте моделі рядки результату (а не базу), щоб вона написала коротке пояснення.
- Показуйте запит, таблицю і пояснення користувачеві, з можливістю позначити неправильну відповідь.
- Логуйте все: запитання, згенерований SQL, час виконання, кількість рядків, відгук користувача.
import re

ALLOWED = re.compile(r"^\s*(with|select)\b", re.I)
FORBIDDEN = re.compile(r"\b(insert|update|delete|merge|drop|alter|create|grant|truncate|copy)\b", re.I)

def safe_sql(sql: str, max_rows: int = 1000) -> str:
    sql = sql.strip().rstrip(";")
    if ";" in sql or not ALLOWED.match(sql) or FORBIDDEN.search(sql):
        raise ValueError("Дозволено лише один запит SELECT на читання")
    if not re.search(r"\blimit\s+\d+\s*$", sql, re.I):
        sql += f"\nLIMIT {max_rows}"
    return sql
Перевірка регулярним виразом — друга лінія захисту, а не перша. Дані насправді захищають роль лише для читання і обмеження схеми. Ставтеся до SQL моделі як до введення від недовіреного користувача.
Приклад: хороша і погана відповідь
Запитання: «Скільки принесли повторні клієнти у вересні?»
Хороша відповідь використовує визначену метрику «повторний клієнт — той, чиє перше оплачене замовлення було до періоду», фільтрує оплачені замовлення вересня в бізнес-поясі і повертає: «Повторні клієнти: 1 140 замовлень, 1,31 млн грн виручки (38% виручки вересня)» — плюс SQL і таблицю за тижнями.
Погана відповідь (яку отримуєте без семантичного шару) трактує «повторних» як «клієнтів з більш ніж одним замовленням у вересні», і всі, хто цього місяця купив один раз, але купував раніше, з неї випадають. Число виглядає правдоподібно і помиляється дуже суттєво. Виправлення — не краща модель, а однорядкове визначення в семантичному контексті та контрольне запитання, яке його перевіряє.
Еталонний набір запитань
| Тип запитання | Приклад | Що перевіряє |
|---|---|---|
| Проста метрика | «Виручка минулого тижня» | логіку дат, часовий пояс, статус оплати |
| Визначений сегмент | «Виручка від повторних клієнтів у вересні» | визначення метрик |
| Розбивка | «Замовлення за каналами цього місяця проти минулого» | з'єднання, групування |
| Коефіцієнт | «Конверсія на мобільних за 30 днів» | чисельник і знаменник з правильних джерел |
| Неоднозначне | «Як продажі?» | ставить уточнювальне запитання, а не вгадує |
| Без відповіді | «Прибуток за блогерами» (таких даних немає) | каже, що даних немає |
Проганяйте набір після кожної зміни контексту чи моделі і відстежуйте частку правильних відповідей. Падіння — це регресія, як у коді.
Вартість і швидкість
Кожне запитання — це один-два виклики моделі (написати SQL і пояснити результат) плюс сам запит. Тримайте семантичний контекст компактним (таблиці й визначення, а не приклади даних) — так менша вартість і час відповіді. Кешуйте відповіді на часті запитання в межах поточного оновлення даних: «виручка вчора», яку о 9 ранку питають п'ятеро людей, потребує одного обчислення, а не п'яти.
Як написати семантичний контекст
Документ контексту — найбільший важіль якості відповідей. Що має бути в хорошому:
- Спочатку бізнес-правила. «Виручка = оплачені замовлення мінус повернення, без ПДВ. Бізнес-часовий пояс: Europe/Kyiv. Тиждень починається з понеділка.»
- Кожна таблиця — одним рядком. Її гранулярність («рядок на замовлення»), ключ і важливі колонки з типами.
- Визначення метрик — SQL-фрагментами, щоб модель копіювала їх, а не вигадувала:
revenue = SUM(revenue_net) WHERE status = 'paid'. - Відомі пастки. «Ніколи не сумуй
sessionsз різних джерел, використовуй лишеmart.daily_sessions.» «ID клієнтів до 2024 року — вlegacy_customer_id.» - Чого немає. Краще, щоб модель відповіла «даних про прибуток за блогерами немає», ніж імпровізувала.
Зберігайте документ під контролем версій поряд із кодом сховища й оновлюйте щоразу, коли змінюється визначення. Це той самий документ, який однаково потрібен вашим аналітикам — асистент лише змушує нарешті його написати.
Часті запитання
Чи замінить ІІ-асистент дашборд?
Ні. Дашборд показує ключові метрики, які треба бачити регулярно. Асистент закриває разові питання і поглиблений аналіз.
Наскільки точні відповіді?
Залежить від якості семантичного шару і складності питання. Прості питання за визначеними метриками зазвичай відповідаються надійно; складні — потребують перевірки. Тому важливо тестувати на власному наборі питань.
Чи безпечно давати моделі доступ до бази?
Лише з обмеженнями: користувач з правом читання, обмежений набір таблиць, ліміти на запити й маскування персональних даних.
З чого почати?
З чітких визначень 10–15 ключових метрик. Без них асистент повторюватиме ту саму плутанину, що й ручні звіти.
DATUMPANEL — Аналітика даних для бізнесу
DATUMPANEL — це незалежний аналітик даних з України. Будую дашборди для власників бізнесу, налаштовую GA4 і експорт у BigQuery, збираю пайплайни даних і автозвіти в Telegram для e-commerce, сервісного бізнесу, SaaS і агенцій — від аудиту даних до рішень.