Експорт GA4 у BigQuery: повний гайд для бізнесу
Навіщо вмикати експорт GA4 у BigQuery, як він влаштований (events_, intraday, event_params), скільки коштує і які SQL-запити дають відповіді, яких немає в інтерфейсі GA4.
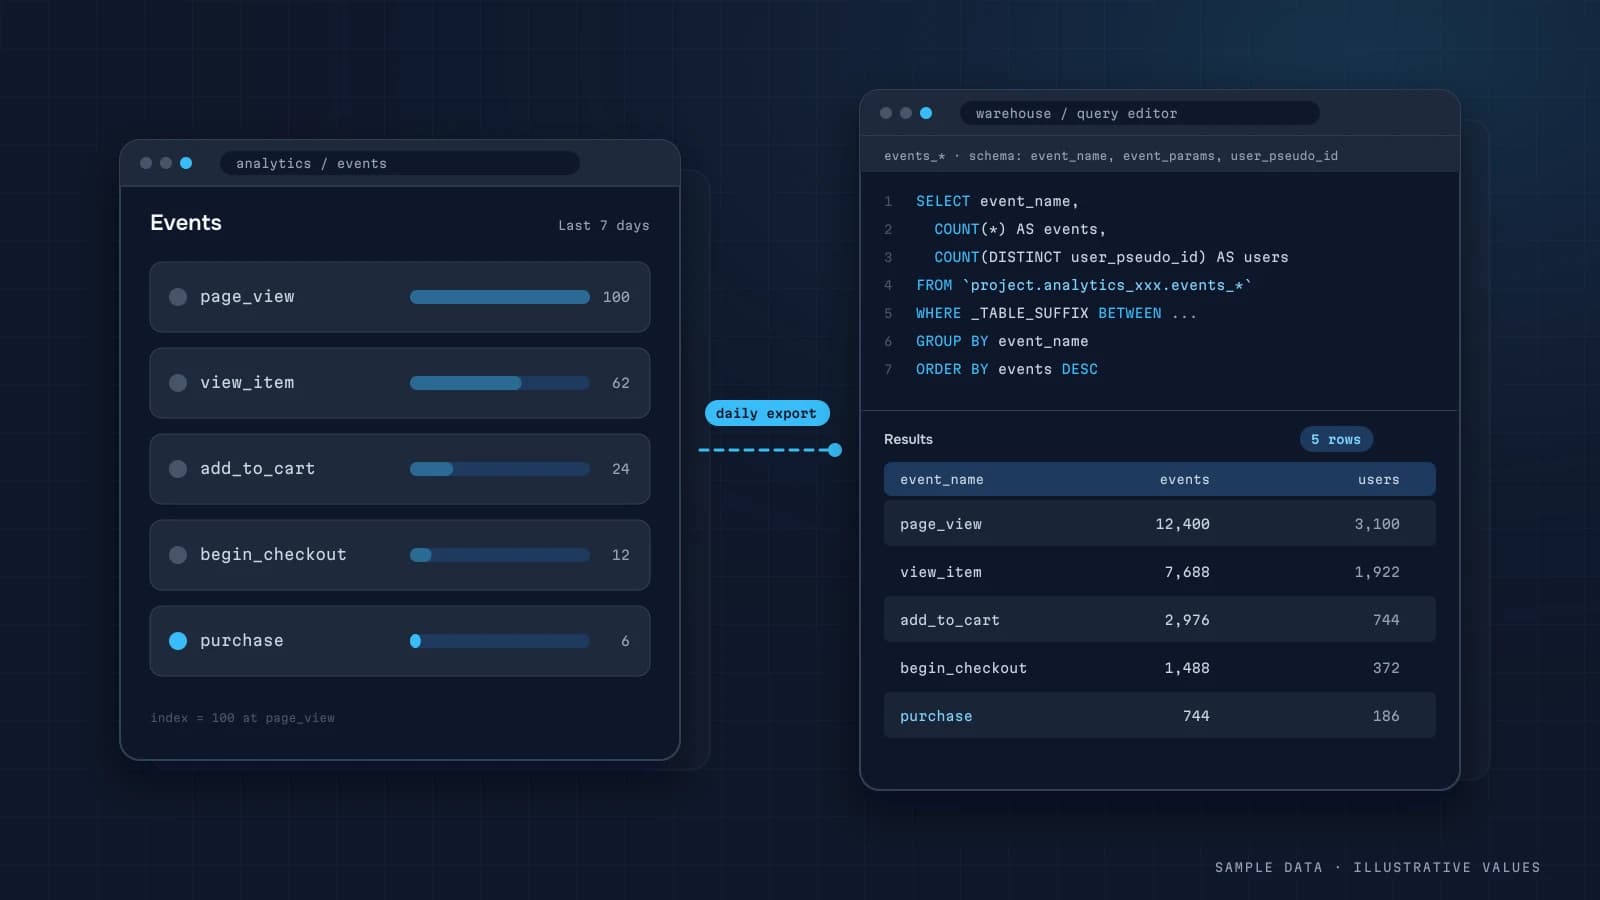
Інтерфейс GA4 добре відповідає на прості запитання: скільки було користувачів, звідки прийшов трафік, яка сторінка популярна. Але щойно власник питає «скільки ми заробили з клієнтів, які вперше прийшли з Meta у березні» чи «чому виручка в GA4 не збігається з CRM», інтерфейса стає замало. Тут потрібні сирі події. Їх дає безкоштовний експорт GA4 у BigQuery.
Нижче — як я налаштовую цей експорт у проєктах, що в ньому лежить, скільки він коштує і з яких запитів варто почати.
Що таке експорт GA4 у BigQuery
Це вбудована інтеграція: GA4 щодня (або безперервно) вивантажує кожну подію вашого сайту чи застосунку в таблицю BigQuery — сховища даних Google Cloud. Не агреговані звіти, а саме події: page_view, view_item, add_to_cart, purchase, з усіма параметрами, джерелом трафіку, пристроєм і гео.
Головні наслідки:
- немає семплювання і порогів, які GA4 застосовує в деяких звітах;
- історія належить вам — GA4 зберігає дані в Explorations обмежений час, а таблиці в BigQuery лежать, скільки ви захочете;
- можна з'єднувати з іншими даними — CRM, рекламними витратами, оплатами з LiqPay чи monobank;
- SQL замість кліків — будь-яке визначення метрики, будь-яка когорта.
Важливо: експорт працює лише з моменту ввімкнення. Історію заднім числом він не вивантажує. Тому вмикати його варто сьогодні, навіть якщо аналізувати плануєте через пів року.
Як влаштовані таблиці
Google описує це в довідці: у датасеті analytics_<ID_ресурсу> створюються таблиці двох типів.
| Таблиця | Коли з'являється | Для чого |
|---|---|---|
events_YYYYMMDD | щоденний експорт, після обробки дня | основна, стабільна таблиця для звітів |
events_intraday_YYYYMMDD | потоковий експорт, протягом дня | «майже живі» дані; видаляється, коли готова денна |
Два нюанси з документації, на які часто натрапляють:
- Денну таблицю GA4 ще може дописувати кілька днів — події, що прийшли із запізненням (наприклад, з Measurement Protocol чи мобільного SDK). Тому пайплайн має перераховувати останні 3 дні, а не лише вчорашній.
- Дата таблиці — у часовому поясі ресурсу GA4. Якщо змінити пояс у налаштуваннях, експорт може дати розбіжність або пропустити день.
Схема: чому все «вкладене»
Один рядок — одна подія. Але параметри події лежать не в окремих колонках, а в повторюваному полі event_params (масив пар ключ–значення). Те саме з товарами — items. Схема експорту містить також блоки device, geo, traffic_source, collected_traffic_source, ecommerce, user_pseudo_id, user_id.
Щоб дістати параметр, використовують UNNEST:
SELECT
  event_date,
  (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'page_location') AS page,
  COUNT(*) AS views
FROM `project.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20261001' AND '20261007'
  AND event_name = 'page_view'
GROUP BY 1, 2
ORDER BY views DESC;
_TABLE_SUFFIX обмежує, які денні таблиці читаються, — це головний інструмент економії.
Як увімкнути: покроково
- Створіть проєкт у Google Cloud і прив'яжіть платіжний акаунт. Без білінгу працює «пісочниця» з обмеженнями, і потоковий експорт у ній недоступний.
- Увімкніть BigQuery API у проєкті.
- У GA4: Адміністратор → Зв'язки з продуктами → BigQuery → «Зв'язати», оберіть проєкт і регіон даних. Регіон потім не зміните — для українського бізнесу з клієнтами в ЄС я зазвичай обираю
EU. - Оберіть частоту: щоденний експорт — майже завжди; потоковий — лише якщо справді потрібні дані протягом дня.
- За потреби виключіть непотрібні події (наприклад, технічні), щоб не платити за їх зберігання.
- Перевірте наступного дня, що з'явилась таблиця
events_за вчора.
Порада: одразу дайте доступ до датасету сервісному акаунту з роллю лише на читання. Саме під ним підключатиметься дашборд чи ETL — без особистих паролів.
Скільки це коштує
Сам експорт безкоштовний. Платите ви BigQuery — за зберігання і за обсяг даних, прочитаних запитами. Актуальні ціни й безкоштовні ліміти дивіться на сторінці тарифів BigQuery — вони залежать від регіону й змінюються.
На практиці для малого й середнього сайту рахунок найчастіше визначає не зберігання, а неакуратні запити. Що реально тримає витрати під контролем:
- завжди фільтрувати
_TABLE_SUFFIX, а неevent_date; - не писати
SELECT *по сирих подіях; - один раз на день будувати агреговані таблиці (сесії, замовлення, денні метрики) і підключати дашборд саме до них;
- встановити ліміт байтів на запит і бюджетні сповіщення в Cloud Billing.
Перші запити, які варто зробити
Google має збірник базових запитів; нижче — ті, з яких я починаю аудит.
Виручка й замовлення по днях
SELECT
  PARSE_DATE('%Y%m%d', event_date) AS day,
  COUNT(DISTINCT ecommerce.transaction_id) AS orders,
  SUM(ecommerce.purchase_revenue) AS revenue
FROM `project.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX BETWEEN FORMAT_DATE('%Y%m%d', DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY))
                        AND FORMAT_DATE('%Y%m%d', CURRENT_DATE())
  AND event_name = 'purchase'
GROUP BY day
ORDER BY day;
Якщо orders помітно менше, ніж у CRM, — це не баг BigQuery, а сигнал про проблеми трекінгу (про причини — у статті чому виручка в GA4 не збігається з CRM).
Дублікати транзакцій
SELECT ecommerce.transaction_id, COUNT(*) AS n
FROM `project.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX >= '20261001' AND event_name = 'purchase'
GROUP BY 1
HAVING n > 1
ORDER BY n DESC;
Дублі зазвичай з'являються, коли подію purchase шле сторінка «Дякуємо», яку користувач оновлює.
Перше джерело користувача
У полі traffic_source лежить джерело першого залучення користувача, а не поточної сесії — це часта пастка. Для сесійних джерел використовуйте collected_traffic_source або параметри подій (детальніше про області атрибуції — у довідці GA4).
SELECT traffic_source.source, traffic_source.medium,
       COUNT(DISTINCT user_pseudo_id) AS new_users
FROM `project.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20261001' AND '20261031'
  AND event_name = 'first_visit'
GROUP BY 1, 2
ORDER BY new_users DESC;Від сирих подій до дашборда
Сирі події — це фундамент, а не звіт. Робочий ланцюжок виглядає так:
| Шар | Що там | Хто читає |
|---|---|---|
| Сирі події | events_* як є | лише ETL |
| Очищений шар | сесії, замовлення без дублів, нормалізовані UTM | аналітик |
| Вітрини | денні KPI, когорти, канали з витратами | дашборд, Telegram-звіти, ШІ-асистент |
Вітрини перебудовуються щоночі; дашборд читає маленькі таблиці і відкривається за секунди. Про те, як збирати такий ланцюжок разом з CRM і рекламними кабінетами, — у гайді про пайплайни даних для малого бізнесу. А приклад готових вітрин для магазину — у статті про когортний аналіз.
Типові помилки
- Увімкнули експорт «колись потім» — і втратили історію за сезон.
- Підключили Looker Studio напряму до
events_*— кожне відкриття звіту читає гігабайти. - Рахують користувачів за
user_id, хоча він заповнений лише для залогінених. - Беруть
traffic_sourceяк джерело сесії. - Не враховують, що дані за останні дні ще дописуються.
- Не налаштували consent mode — і дивуються, що частини подій немає (див. consent mode і аналітика).
Чекліст запуску
- Проєкт Google Cloud з білінгом і бюджетним сповіщенням
- Регіон датасету обрано свідомо (EU/US)
- Щоденний експорт увімкнено, потоковий — лише за потреби
- Сервісний акаунт з доступом лише на читання
- Перевірено події ecommerce:
transaction_id,value,currency,items - Нічний розрахунок вітрин з перерахунком останніх 3 днів
- Дашборд читає вітрини, а не сирі події
Відновлюємо сесії і джерела трафіку в SQL
В експорті немає таблиці «сесії». Сесію визначає пара user_pseudo_id + параметр події ga_session_id. Запит нижче будує один рядок на сесію зі сторінкою входу і джерелом. Це основа, яку ви адаптуєте під себе, а не готова заміна інтерфейсу GA4.
WITH ev AS (
  SELECT
    user_pseudo_id,
    (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'ga_session_id') AS session_id,
    TIMESTAMP_MICROS(event_timestamp) AS ts,
    event_name,
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'page_location') AS page,
    collected_traffic_source.manual_source  AS src,
    collected_traffic_source.manual_medium  AS med,
    collected_traffic_source.gclid          AS gclid
  FROM `project.analytics_123456.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
)
SELECT
  user_pseudo_id, session_id,
  MIN(ts) AS session_start,
  ARRAY_AGG(page IGNORE NULLS ORDER BY ts LIMIT 1)[SAFE_OFFSET(0)] AS landing_page,
  ARRAY_AGG(src  IGNORE NULLS ORDER BY ts LIMIT 1)[SAFE_OFFSET(0)] AS source,
  ARRAY_AGG(med  IGNORE NULLS ORDER BY ts LIMIT 1)[SAFE_OFFSET(0)] AS medium,
  LOGICAL_OR(gclid IS NOT NULL) AS has_gclid,
  COUNTIF(event_name = 'purchase') AS purchases
FROM ev
GROUP BY 1, 2;
Нотатки з реальних проєктів:
- Не беріть верхньорівневий
traffic_sourceдля сесій. Цей запис описує перше залучення користувача, а не поточну сесію. Використовуйте поляcollected_traffic_sourceна рівні подій (або, в новіших експортах, сесійні поля last-click, які додала Google). Перевірте свою схему — експорт постійно змінюється. - Сесії з
gclid, але без джерела — це трафік Google Ads з автотегуванням. Зіставляйте їх ізgoogle / cpcсамостійно. - Числа відрізнятимуться від інтерфейсу GA4 на кілька відсотків. Інтерфейс застосовує моделювання, пороги і власну атрибуцію. Для рішень важливіша послідовність, ніж точний збіг з інтерфейсом.
Як тримати витрати передбачуваними
BigQuery рахує запити on-demand за обсягом просканованих даних (актуальні тарифи і безкоштовний ліміт — на сторінці цін). Таблиці експорту широкі, тож необережний запит сканує значно більше, ніж треба. Звички, що тримають рахунок малим:
| Звичка | Навіщо |
|---|---|
Завжди фільтрувати _TABLE_SUFFIX | сканує лише потрібні дні |
| Вибирати лише потрібні колонки | SELECT * по експорту читає всі вкладені поля |
| Один раз будувати щоденну агреговану таблицю | дашборди читають кілька МБ замість сирого експорту |
| Дивитись оцінку валідатора перед запуском | показує, скільки байтів обробить запит |
| Встановити денну квоту на запити | жорстка межа від «запитів-утікачів» |
Оцінка витрат на прикладі (ілюстративно)
Припустимо, магазин генерує близько 50 000 подій на день, і кожен рядок у колонках, які ви реально запитуєте, займає в середньому ~1 КБ. Місяць — це ~1,5 млн рядків, близько 1,5 ГБ. Перебудова щоденного зведення з учорашньої таблиці щоранку сканує ~50 МБ — це дрібниця. А дашборд, що на кожну зміну фільтра запитує сирий місяць, сканує 1,5 ГБ щоразу, і коли команда клікає весь день, це швидко накопичується. Різницю робить агрегована таблиця, а не обсяг трафіку.
Щоденна перебудова за розкладом
Найпростіше надійне рішення — запланований запит у BigQuery, що запускається після появи денного експорту (денні таблиці зазвичай з'являються протягом наступного дня, тож не ставте на 00:05):
-- щодня, пише в analytics_mart.daily_sessions (партиціонована за днем)
DECLARE d STRING DEFAULT FORMAT_DATE('%Y%m%d', DATE_SUB(CURRENT_DATE(), INTERVAL 1 DAY));

DELETE FROM analytics_mart.daily_sessions WHERE day = PARSE_DATE('%Y%m%d', d);

INSERT INTO analytics_mart.daily_sessions
SELECT PARSE_DATE('%Y%m%d', event_date) AS day,
       COALESCE(collected_traffic_source.manual_source, '(direct)') AS source,
       COUNT(DISTINCT CONCAT(user_pseudo_id, CAST((SELECT value.int_value FROM UNNEST(event_params) WHERE key='ga_session_id') AS STRING))) AS sessions,
       COUNTIF(event_name = 'purchase') AS purchases
FROM `project.analytics_123456.events_*`
WHERE _TABLE_SUFFIX = d
GROUP BY 1, 2;
Схема «видалити і вставити за один день» робить задачу безпечною для повторного запуску: якщо вчорашній експорт запізнився чи був перероблений, просто запустіть знову. Після запуску додайте перевірку, що день має рядки: порожній день має когось сповістити, а не тихо лежати в дашборді.
Об'єднуємо GA4 з бекендом
Справжня цінність експорту з'являється, коли ви з'єднуєте його із замовленнями з CRM або бази магазину. Використовуйте transaction_id із запису ecommerce події purchase:
| Експорт GA4 дає | Бекенд дає | Разом отримуєте |
|---|---|---|
| джерело/канал, сторінку входу, пристрій | реальну оплачену суму, повернення, маржу | маржу за каналом і сторінкою входу |
| user_pseudo_id між сесіями | ID клієнта і повторні замовлення | повторні покупки за каналом першого контакту |
| події воронки | статус доставки, повернення | який трафік приводить замовлення, що повертають |
Переконайтеся, що сайт передає в GA4 той самий ID замовлення, що зберігає бекенд. Це найцінніший рядок у всьому трекінгу. Детальніше — у статті про трекінг e-commerce в GA4.
Денний, потоковий експорт і таблиці користувачів: що вмикати
У налаштуваннях експорту є кілька варіантів, і поводяться вони по-різному:
| Варіант | Що отримуєте | Коли потрібно |
|---|---|---|
| Щоденний | events_YYYYMMDD, одна повна таблиця на день | завжди — це основа звітності |
| Потоковий | events_intraday_YYYYMMDD, оновлюється протягом дня | лише якщо хтось справді діє за даними того ж дня |
| Дані користувачів | таблиці користувачів (псевдонімні та за User-ID) | для аналізу аудиторій і життєвого циклу |
Що варто знати, перш ніж на це покладатися (актуальні обмеження — у документації Google щодо експорту, вони змінюються):
- Стандартні ресурси мають денний ліміт подій для щоденного експорту. Якщо великий сайт його перевищує, щоденний експорт можуть призупинити. У потокового такого ліміту немає, але BigQuery тарифікує його як потокові дані.
- Intraday-таблиці замінюються, коли денна таблиця за цей день готова, тож ніколи не будуйте постійну історію на intraday.
- Експорт починається з дня підключення. Історію раніше не довантажити, тому підключайте BigQuery якомога раніше, навіть якщо найближчі місяці не плануєте робити запити.
- Запізнілі події можуть оновити кілька останніх днів. Якщо щоранку перебудовувати ковзне вікно з останніх 3 днів, а не лише вчора, агрегат залишається чесним.
На практиці для малого й середнього бізнесу: щоденний експорт — з першого дня, потоковий — вимкнений, доки немає конкретної задачі на дані того ж дня, таблиці користувачів — увімкнені, якщо плануєте когорти чи LTV.
Часті запитання
Чи можна вивантажити історію GA4 за минулі місяці?
Ні. Експорт пише дані лише з дня ввімкнення. Минулі періоди можна частково отримати через Data API GA4, але це агрегати зі звітів, а не сирі події.
Безкоштовний GA4 підтримує експорт у BigQuery?
Так, експорт доступний і в стандартному GA4. Для стандартних ресурсів діють ліміти на обсяг щоденного експорту — актуальні значення вказані в довідці Google про BigQuery Export.
Чи потрібен програміст, щоб працювати з BigQuery?
Для ввімкнення — ні, це кілька кліків. Для корисних звітів потрібен SQL і розуміння схеми. Зазвичай аналітик один раз будує вітрини, а далі власник дивиться на готовий дашборд.
Чим відрізняються дані BigQuery від звітів GA4?
У BigQuery немає семплювання, порогів і моделювання відсутніх даних, а атрибуцію ви рахуєте самі. Тому цифри можуть трохи відрізнятися від інтерфейсу — і це нормально, якщо ви знаєте, чому.
Як часто оновлюються дані?
Щоденна таблиця з'являється наступного дня і ще може доповнюватися кількома днями пізніше. Потоковий експорт дає дані протягом дня, але Google не гарантує їх повноту.
DATUMPANEL — Аналітика даних для бізнесу
DATUMPANEL — це незалежний аналітик даних з України. Будую дашборди для власників бізнесу, налаштовую GA4 і експорт у BigQuery, збираю пайплайни даних і автозвіти в Telegram для e-commerce, сервісного бізнесу, SaaS і агенцій — від аудиту даних до рішень.